大數(shù)據(jù)開發(fā)中最常用的編程語(yǔ)言與數(shù)據(jù)處理和存儲(chǔ)服務(wù)
引言
隨著數(shù)據(jù)量的爆炸式增長(zhǎng),大數(shù)據(jù)開發(fā)已成為企業(yè)挖掘數(shù)據(jù)價(jià)值的關(guān)鍵環(huán)節(jié)。在大數(shù)據(jù)生態(tài)中,選擇合適的編程語(yǔ)言和數(shù)據(jù)處理、存儲(chǔ)服務(wù)至關(guān)重要。本文將介紹大數(shù)據(jù)開發(fā)中最常用的編程語(yǔ)言,以及主流的數(shù)據(jù)處理與存儲(chǔ)服務(wù),幫助開發(fā)者快速構(gòu)建高效的數(shù)據(jù)管道。
一、大數(shù)據(jù)開發(fā)中最常用的編程語(yǔ)言
1. Java
Java 是大數(shù)據(jù)生態(tài)的基石,Hadoop、Spark、Flink、Kafka 等核心框架均主要使用 Java 開發(fā)。Java 擁有成熟的 JVM 生態(tài)、豐富的類庫(kù)和強(qiáng)大的跨平臺(tái)能力,適合構(gòu)建大規(guī)模分布式系統(tǒng)。
2. Scala
Scala 運(yùn)行在 JVM 上,兼具面向?qū)ο蠛秃瘮?shù)式編程特性。由于 Apache Spark 和 Apache Kafka 均使用 Scala 編寫,Scala 在數(shù)據(jù)工程領(lǐng)域廣受歡迎。其簡(jiǎn)潔的語(yǔ)法和強(qiáng)大的并發(fā)模型能夠顯著提升開發(fā)效率。
3. Python
Python 憑借簡(jiǎn)單易學(xué)、豐富的科學(xué)計(jì)算庫(kù)(如 Pandas、NumPy)和活躍的社區(qū),成為數(shù)據(jù)分析和機(jī)器學(xué)習(xí)首選語(yǔ)言。PySpark、Dask 等框架讓 Python 也能處理大規(guī)模數(shù)據(jù),適合快速原型開發(fā)和數(shù)據(jù)探索。
4. SQL
雖然 SQL 不是通用編程語(yǔ)言,但在大數(shù)據(jù)開發(fā)中地位不可替代。Hive、Spark SQL、Presto/Trino、Flink SQL 等允許開發(fā)者用聲明式語(yǔ)句進(jìn)行數(shù)據(jù)查詢和轉(zhuǎn)換,極大降低了大數(shù)據(jù)處理門檻。
5. Go 和 Rust
隨著云原生和實(shí)時(shí)數(shù)據(jù)處理的發(fā)展,Go 和 Rust 逐漸進(jìn)入大數(shù)據(jù)領(lǐng)域。Go 適合構(gòu)建高并發(fā)的數(shù)據(jù)采集和微服務(wù),Rust 則用于對(duì)性能要求極高的場(chǎng)景(如流處理引擎)。
二、數(shù)據(jù)處理服務(wù)
數(shù)據(jù)處理服務(wù)負(fù)責(zé)對(duì)海量數(shù)據(jù)進(jìn)行清洗、轉(zhuǎn)換、聚合和分析。常見服務(wù)包括:
- Apache Hadoop MapReduce:經(jīng)典的批處理框架,適合離線大規(guī)模數(shù)據(jù)處理,但延遲較高。
- Apache Spark:基于內(nèi)存的分布式計(jì)算引擎,支持批處理、流處理、機(jī)器學(xué)習(xí)和圖計(jì)算,性能遠(yuǎn)超 MapReduce。
- Apache Flink:原生流處理框架,提供 exactly-once 語(yǔ)義和低延遲,適合實(shí)時(shí)數(shù)據(jù)處理。
- Apache Kafka Streams:基于 Kafka 的輕量級(jí)流處理庫(kù),適合構(gòu)建實(shí)時(shí)數(shù)據(jù)管道。
- Apache Beam:統(tǒng)一的編程模型,可運(yùn)行在 Spark、Flink 等引擎上,實(shí)現(xiàn)批流一體。
- 云托管服務(wù):如 AWS Glue、Google Cloud Dataflow、阿里云實(shí)時(shí)計(jì)算 Flink 版,提供免運(yùn)維的數(shù)據(jù)處理能力。
三、數(shù)據(jù)存儲(chǔ)服務(wù)
數(shù)據(jù)存儲(chǔ)服務(wù)為大數(shù)據(jù)提供持久化、高可靠、可擴(kuò)展的存儲(chǔ)方案。主要分為以下幾類:
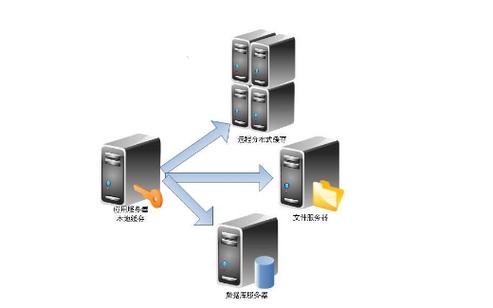
- 分布式文件系統(tǒng):HDFS(Hadoop Distributed File System)是大數(shù)據(jù)存儲(chǔ)的基石,適合海量文件存儲(chǔ)。
- NoSQL 數(shù)據(jù)庫(kù):
- HBase:基于 HDFS 的列式數(shù)據(jù)庫(kù),支持海量數(shù)據(jù)的隨機(jī)讀寫。
- Cassandra:高可用的分布式列存儲(chǔ),適合寫多讀少場(chǎng)景。
- MongoDB:文檔型數(shù)據(jù)庫(kù),適合半結(jié)構(gòu)化數(shù)據(jù)。
- 對(duì)象存儲(chǔ):如 AWS S3、阿里云 OSS、騰訊云 COS,提供低成本、高擴(kuò)展的存儲(chǔ),常與 Spark、Hadoop 集成。
- 數(shù)據(jù)倉(cāng)庫(kù):
- Apache Hive:基于 Hadoop 的數(shù)據(jù)倉(cāng)庫(kù),提供 SQL 接口。
- ClickHouse:列式 OLAP 數(shù)據(jù)庫(kù),查詢速度極快。
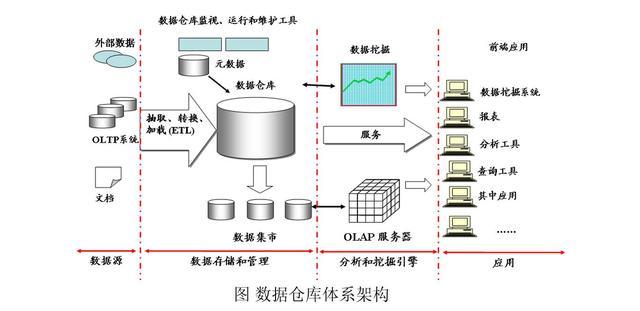
- Apache Doris / StarRocks:新一代 MPP 數(shù)據(jù)倉(cāng)庫(kù),支持實(shí)時(shí)分析。
- Snowflake / BigQuery / Redshift:云原生數(shù)據(jù)倉(cāng)庫(kù),彈性擴(kuò)展。
- 時(shí)序數(shù)據(jù)庫(kù):如 InfluxDB、TimescaleDB,用于存儲(chǔ)監(jiān)控指標(biāo)和 IoT 數(shù)據(jù)。
- 圖數(shù)據(jù)庫(kù):如 Neo4j、JanusGraph,用于社交網(wǎng)絡(luò)和知識(shí)圖譜。
四、如何選擇
選擇編程語(yǔ)言和數(shù)據(jù)處理存儲(chǔ)服務(wù)時(shí)需考慮以下因素:
- 數(shù)據(jù)規(guī)模與延遲要求:批處理可選擇 Java/Scala + Spark/HDFS;實(shí)時(shí)處理可選 Flink/Kafka;交互式分析可選 Presto/ClickHouse。
- 團(tuán)隊(duì)技能:Python 團(tuán)隊(duì)可優(yōu)先使用 PySpark 和 Pandas;Java 團(tuán)隊(duì)更適合 Hadoop/Spark 原生開發(fā)。
- 成本與運(yùn)維:云托管服務(wù)減少運(yùn)維負(fù)擔(dān),但可能產(chǎn)生較高費(fèi)用;自建集群初期成本低,但需專業(yè)運(yùn)維。
- 生態(tài)整合:確保所選語(yǔ)言和存儲(chǔ)服務(wù)能與現(xiàn)有系統(tǒng)(如數(shù)據(jù)湖、消息隊(duì)列)無(wú)縫集成。
##
大數(shù)據(jù)開發(fā)中,Java 和 Scala 是構(gòu)建核心框架的主力,Python 和 SQL 則因易用性成為數(shù)據(jù)分析和查詢的利器。數(shù)據(jù)處理服務(wù)從批處理的 Hadoop/Spark 到流處理的 Flink/Kafka,存儲(chǔ)服務(wù)從 HDFS 到云數(shù)據(jù)倉(cāng)庫(kù),提供了豐富的選擇。開發(fā)者應(yīng)根據(jù)業(yè)務(wù)需求、團(tuán)隊(duì)能力和成本預(yù)算,組合使用這些語(yǔ)言和服務(wù),構(gòu)建高效、可靠的大數(shù)據(jù)平臺(tái)。
最新產(chǎn)品